(大学のeスポーツサークル時代、同じ VALORANT の試合を 4視点並列 で観てたんですよ。① プロ実況のYouTube配信(戦略解説)、② 自分のサブアカで対戦(プレイ感覚)、③ マップ全体の俯瞰観戦カメラ(位置情報)、④ 海外RedditのVALORANTスレ(メタ分析の英文)。4画面+Discord通話で 同時に走らせる。これで強くなった。)
(土曜の22時に Discord で「先輩いま起きてますか」って連絡来て、画面共有で見せられているのがコレ…ただ、これは完全に マルチヘッドアテンション だ。同じ試合 = 1つの単語、4視点 = 4ヘッド、それぞれ 別空間で並列 に文脈を読んで、最後に統合して 「勝ち筋」 を出す。…川口、ちゃんと寝てる?)
(先輩、先週読み返した “Attention Is All You Need” の 8ヘッド構造、これが完全に学生時代の4視点並列と同じ仕組みなんです。今は当社の クライアント提案レビュー も 5視点並列(売上/競合/技術/組織/法務)で走らせていて、これも実質マルチヘッド…あ、コーラ切れた、買ってきます。)
(土曜深夜にコーラ買いに行くな…でも、確かに彼の 「並列吸収」 は本物だ。)
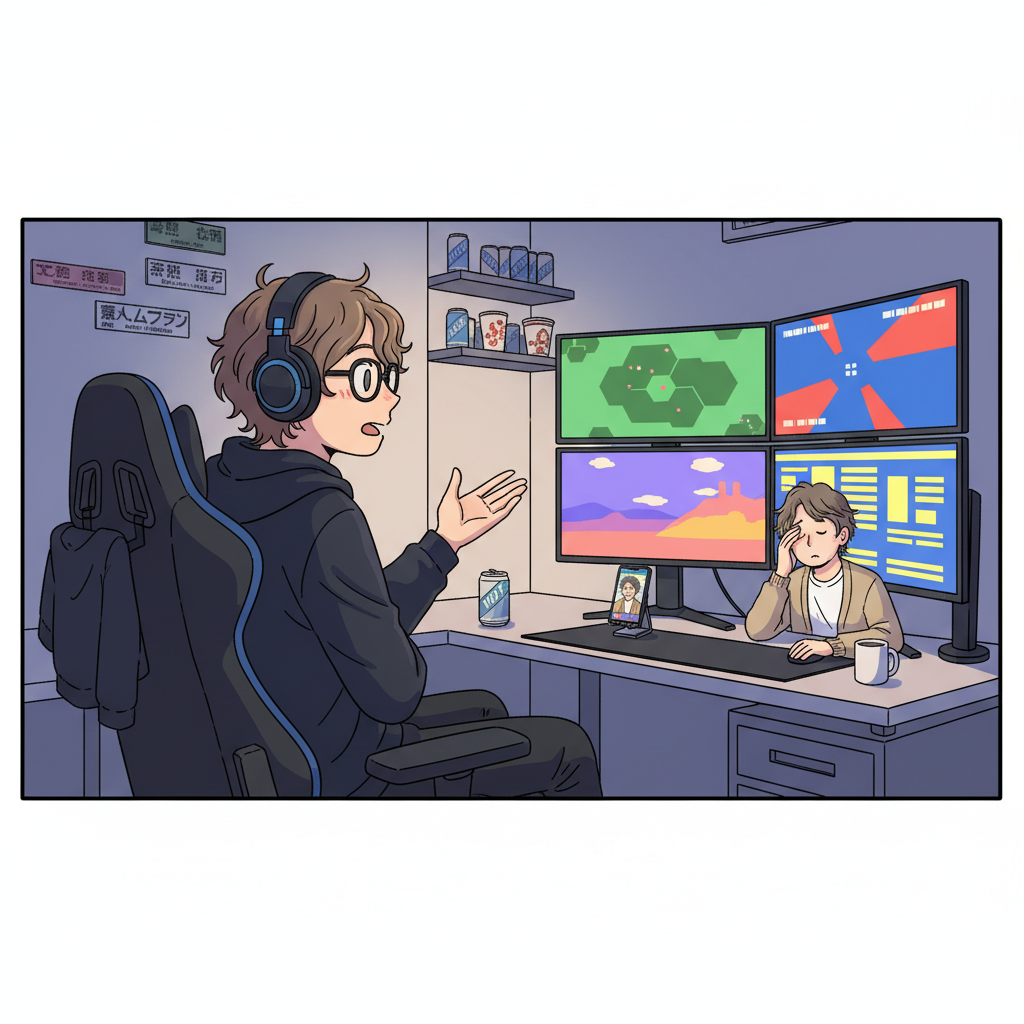
- ひとことで言うと、同じ文章を複数の視点で同時に読む 仕組み。Q/K/V を 1組ではなく h 組(典型 8〜16) 並べて、文脈を読み解く担当を増やす拡張。
- 視点が増えるほど、語順・主語と動詞・修飾関係など 別々の手がかりを取りこぼさず拾える。これが Transformer の性能を大きく押し上げた要因のひとつ。
- イメージは、1つの文章を複数の専門家が別の観点で同時に読む 編集会議。最後に全員の読みを 1本にまとめ直す(統合の中身は本文で)。
Q/K/V (#035) で、アテンションの中身が 3つの行列演算 で書けると見た。あれは 「1組」 の話。実は Transformer はこの Q/K/V を h 組 並列 で走らせている。なぜか、何が嬉しいのか。
キーワードは 「視点並列」。同じ文章を、別の角度から同時に読む — これが Transformer が言語理解で性能を出した、いちばん根の深い理由のひとつ。
マルチヘッドとは — Q/K/V を h 組 用意する
マルチヘッドアテンションの仕組みは、単純に書くとこうなる:
- 単一ヘッド(これまでの話): 1組の重み行列 (W_Q, W_K, W_V) で、1つの Attention を計算する。出力は1本のベクトル。
- マルチヘッド(実物の Transformer): h 組の重み行列 (W_Q^i, W_K^i, W_V^i) を用意し、並列に h 個の Attention を計算する。各ヘッドが独立に「自分なりの文脈解釈」を出す。最後に h 個の出力を横にくっつけて(concat)、もう1つの行列 W_O で線形変換して、1本のベクトルに戻す。
h は原典の 「Attention Is All You Need」(Vaswani et al., 2017)では 8。現在の LLM では 16, 32, 64, 96 など、モデルサイズに応じて拡張されている。

なぜ 「1ヘッド」 では足りないのか
1組の Q/K/V で計算するアテンションは、1つの確率分布(softmax の出力)を作る装置。つまり「ある単語が、文中の他のどの単語に注目するか」を 1パターン しか同時に表現できない。
これでは現実の言語理解には足りない。同じ単語に対して、人間は同時に 複数の関係性 を見ている:
- 構文の関係 — 主語と動詞の対応、修飾語と被修飾語
- 意味の関係 — 同義語、反義語、上位概念
- 位置の関係 — 直前の単語、文末との距離
- 話題の関係 — 文章全体のテーマとの関連
1ヘッドだと、これらのどれか1つしか同時に扱えない。ヘッドを h 個に分けて並列に走らせると、各ヘッドが別の関係性を担当して、文脈を多角的に組み立てられる。
emergent な役割分担 — 各ヘッドが勝手に 「視点」 を分ける
面白いのは、各ヘッドにどの関係性を担当させるか、人間が 事前に指示しない ところ。h 個のヘッドの重み行列は、全部 ランダム初期化 から訓練が始まる。それが訓練を通じて、自然と 役割が分担される。
解釈論文(Clark et al., 2019 「What Does BERT Look At?」 など)では、訓練済み Transformer の各ヘッドが具体的にどんな関係性を学習しているか観測されている。例:
- ヘッド A: 各単語が 直前の単語 に強く注目(位置的隣接)
- ヘッド B: 動詞が 主語の名詞 に注目(統語的対応)
- ヘッド C: 代名詞が 前出の名詞 に注目(指示関係の解決)
- ヘッド D: 名詞が 修飾する形容詞 に注目(修飾関係)
- ヘッド E: 文末の句読点が 文全体 に注目(文の境界把握)
これは 創発的(emergent) な現象で、訓練データから 「どう分担するのが損失を最小化するか」 を h 個のヘッドが自動で見つけ出す。人間が「お前は構文係、お前は意味係」と言うわけではない。

計算コスト — h を増やしても安く済む仕掛け
素朴に考えると「ヘッドを h 個並列で走らせるなら、計算量も h 倍になるのでは?」と思える。実は、そうならない。仕掛けは 「各ヘッドの次元を意図的に薄くする」 ところにある。順を追って見る。
ステップ① まず、アテンションの計算量は 「ベクトルの厚み」 に比例する
アテンションの中心は Q と K の内積(関連スコア計算)(#005)。1回の内積コスト ≒ ベクトル次元 D に比例(D 個の掛け算と D 個の足し算が必要)。
単一ヘッドだと Q/K の次元 = d_model のまま。例: d_model = 512 → 内積1回のコスト目安 = 512。
ステップ② マルチヘッドにすると、各ヘッドの次元を 1/h に 「細切り」 にする
h ヘッドに分割する際、各ヘッドの Q/K/V の次元を d_k = d_model / h に絞るのが Transformer の設計ルール。例: d_model = 512, h = 8 → 各ヘッドの次元 d_k = 64。
つまり 「512次元の太いベクトル1本」 を 「64次元の細いベクトル8本」 に細切り にしている。各ヘッドは「薄く狭い視野」しか見ない。

ステップ③ 1ヘッドあたりの内積コストも 1/h に減る
内積コストは次元に比例するので、1ヘッドあたりのコスト = d_k = 64(単一ヘッドの 1/8 倍)。次元を薄くしたぶん、各ヘッドは速い。
ステップ④ h 個並列で合計しても、単一ヘッドと同じ
これを h 個 並列に走らせるので、合計コスト = h × d_k = h × (d_model / h) = d_model。例: 8 × 64 = 512 = 単一ヘッドと ぴったり同じ。
| 各ヘッドの次元 | 1ヘッドのコスト目安 | ヘッド数 | 合計 | |
|---|---|---|---|---|
| 単一ヘッド | 512 | 512 | × 1 | 512 |
| マルチヘッド(h=8) | 64 | 64 | × 8 | 512 |

「ピザの面積は同じだが、1ピースを8切れに分けて配る」イメージ。トータルは変わらないが、8人が同時に別の場所をかじれるようになる、というのがマルチヘッドのメリット。
結果として 「視点を増やすけれど、各視点の解像度は下げる」 という設計が成立。1つの視点で深く見るより、複数の視点で浅く広く見るほうが、言語理解では性能が出るという経験則がここにある。
つまりマルチヘッドは 「ほぼ無料で性能を上げる」 拡張。追加コストは concat 後の W_O 行列 1個分 だけ。これが Transformer の標準装備になっている理由。
コンサル感覚 — 「察し」 の並列度を分解する
Q/K/V (#035) で、大蔵の 「接客の察し」 は 3つの台帳(質問・見出し・本文)で説明できる、と見た。マルチヘッドはここから更に1段進んで、その 「察し」 を h 個の独立フィルタで並列に走らせる 仕組み。
大蔵の実際の接客は、お客様に対して 同時に複数のフィルタ で察している:
- フィルタ①: 年齢層 + 服装(=客層判定ヘッド)
- フィルタ②: 同伴者の有無(=シーン判定ヘッド)
- フィルタ③: 前回の注文履歴(=継続性判定ヘッド)
- フィルタ④: 季節・時間帯(=季節要因ヘッド)
- フィルタ⑤: 表情の微変化(=感情ヘッド)
これが大蔵が 「達人」 である理由 = 並列フィルタを多重に持っている。1フィルタしか持たない接客係は 「表面的な察し」 で止まる。
コンサル提案レビューでの応用: クライアントの 「AI 文脈理解」 要件を、「何ヘッド相当の察しが必要か」 で評価すると、ベンダー実装の妥当性を判定しやすい。例えば顧客サポート AI なら、「商品系 / 感情系 / 緊急度系 / 履歴系 / 個人属性系」の5ヘッド相当が最低ライン、というように。
先輩、土曜の深夜にお話しした件、提案資料に 「ヘッド数換算」 という新指標を入れました。顧客サポートAIのベンダー評価軸、商品系/感情系/緊急度系/履歴系/個人属性系の 5ヘッド相当 以上ないと 「達人レベルの察し」 にならない、という根拠付き比較表です。47スライドあります。
あら、川口さん、”5ヘッド相当の察し” って、私の 20年の銀座カフェ接客 はどう見積もっていらっしゃるの? 表情・年齢・同伴者・前回注文・季節・天気・お客様の声のトーン…これで 少なくとも7ヘッド はあると思いますの。あと、私には 「昼前のお客様の二日酔い度」 という独自ヘッドもございますわ。
フッ、マルチヘッドか。私の場合は ベルリンフィルの定期演奏会 で言うと、同じシンフォニーを 首席指揮者の解釈、客演指揮者の解釈、ライブ録音、CDマスタリング、配信アーカイブ と 5視点並列 で吸収してきた。これが私の “知性のヘッド数“…
(やっと レコード盤じゃない比喩 を出してきましたわね。…でも、それ 結局オーディオ周辺 でしょう?)
御託さん、その5視点、確かに 並列ですが d_k が圧倒的に低い 印象です。…で、川口の提案、「5ヘッド相当」 を比較表の評価軸 に入れるのは筋がいい。クライアントに 「なぜこのベンダーがいいのか」 を 1枚の表 で見せられるなら、刺さる。あと、川口、土曜深夜に Discord で起こすの、来週から控えてね。
マルチヘッドの 「深さ」 — Transformer ブロックごとに h ヘッド
もう一段の構造として、Transformer ブロックは何層にも積まれる(典型 12層、24層、80層、120層…)(#032)。各層の中に 独立した h ヘッド がある。

つまり「層数 × ヘッド数」の 掛け算 でアテンションのフィルタ数が決まる:
- GPT-2 small: 12層 × 12ヘッド = 144 個の独立アテンションフィルタ
- GPT-3 175B: 96層 × 96ヘッド = 9,216 個の独立フィルタ
- 各フィルタが文脈の異なる関係性を担当する、と思うと、LLM がなぜここまで多彩な言語タスクをこなせるかの一端が見える
